Blogue Comment fonctionne Knolt
Security-Bench 1.2 à 1.3 : comment nous testons Knolt face à l’IA de pointe
Ce que demande notre banc d’essai, ce qui change de 1.2 à 1.3, et comment Talos se compare aux modèles d’IA de pointe sur les incidents de sécurité.
Ingénierie de Knolt 5 min de lecture
Security-Bench est le test que nous faisons passer à Knolt et aux modèles d’IA de pointe avant chaque version. Il pose une seule question, comme l’équipe de sécurité d’une banque la pose : est-ce un incident de sécurité? Cet article couvre les deux versions jusqu’ici, ce que nous avons changé entre elles et comment Talos s’en est tiré.
Pourquoi notre propre banc d’essai
Les bancs d’essai vidéo publics testent la compréhension générale : ce qu’il y a dans une scène, ce qui se passe ensuite. Aucun ne teste le jugement qu’un centre des opérations de sécurité porte plusieurs fois par jour, sur une caméra fixe, depuis un coin en hauteur, dans une succursale. Nous en avons donc bâti un. Chaque modèle reçoit les mêmes images et la même question, mot pour mot.
Security-Bench 1.2 : le vol qualifié, demandé deux fois
Security-Bench 1.2 portait seulement sur le vol qualifié. Chaque modèle voyait des images de caméras de sécurité publiques et disait si un vol qualifié était en cours. Puis nous montrions de nouveau les mêmes images à chaque modèle, pour voir s’il donnait la même réponse.
En exactitude, tout le monde était proche : Talos 1.0 a vu juste sur le vol qualifié dans 64 % des cas, contre 62 % pour GPT-6.1 Sol. L’écart était dans la constance. Devant les mêmes images deux fois, Knolt a donné la même réponse chaque fois. GPT-6.1 Sol, dans 41 % des cas. Pour une équipe de sécurité, un système qui change d’avis sur les mêmes images est un système sur lequel elle ne peut pas compter.
Le test a aussi montré ses limites. Le vol qualifié n’est qu’un des nombreux incidents d’une succursale. Un simple oui ou non ne montre pas à quel point un modèle est sûr de lui. Et il ne mesurait pas la durée de chaque requête.
Ce qui change dans Security-Bench 1.3
- Six types d’incidents. Vol qualifié, violence, vol et dissimulation, caméra sabotée, personne au sol, et fumée ou feu.
- Des moments trompeurs, exprès. Des moments ordinaires qui ne font que ressembler à un incident, comme une accolade ou des papiers échappés. Un modèle qui signale tout obtient un mauvais score.
- De vraies images et des scènes mises en scène, toutes étiquetées. De vraies images de caméras de sécurité, et de courtes scènes filmées comme les voit une caméra de sécurité, pour couvrir chaque type d’incident.
- Une probabilité, pas un oui ou non. Chaque modèle dit à quel point un incident est probable. Cela permet de mesurer la qualité du classement (AUC) et de compter les alertes qui étaient réelles et les moments ordinaires laissés tranquilles, pas seulement les bonnes réponses.
- La vitesse, de bout en bout. Le temps médian pour répondre à une requête. Les autres modèles répondent par l’API de leur fabricant, réseau compris.
- Des concurrents plus forts. Claude Opus 5.5 s’est joint à GPT-6.1 Sol et à Claude Sonnet 5.5.
Résultats de Security-Bench 1.3
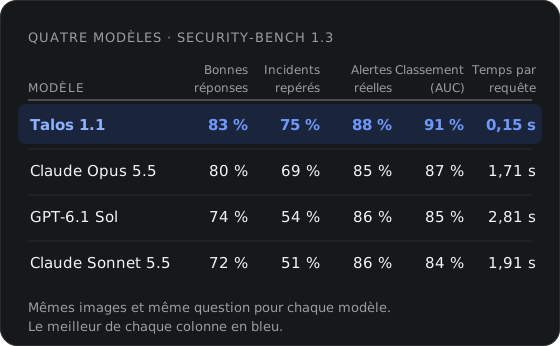
Talos 1.1 a vu juste dans 83 % des cas et a repéré 75 % des incidents. Claude Opus 5.5, le meilleur des autres, a vu juste dans 80 % des cas et en a repéré 69 %. L’écart se creuse sur les incidents repérés.
| Mesure | Talos 1.1 | Claude Opus 5.5 | GPT-6.1 Sol | Claude Sonnet 5.5 |
|---|---|---|---|---|
| Bonnes réponses sur les incidents | 83 % | 80 % | 74 % | 72 % |
| Incidents repérés | 75 % | 69 % | 54 % | 51 % |
| Alertes qui étaient réelles | 88 % | 85 % | 86 % | 86 % |
| Moments ordinaires laissés tranquilles | 91 % | 89 % | 92 % | 92 % |
| Qualité du classement (AUC) | 91 % | 87 % | 85 % | 84 % |
| Temps par requête | 0,15 s | 1,71 s | 2,81 s | 1,91 s |
Knolt répond en 0,15 s : 11 fois plus vite que Claude Opus 5.5 et 18 fois plus vite que GPT-6.1 Sol. Là où nous perdons, nous le disons : deux modèles laissent un peu plus de moments ordinaires tranquilles, 92 % contre nos 91 %.
Ce qui change dans Talos 1.1
- Repère davantage. Meilleur pour repérer les incidents des six types, y compris une personne derrière le comptoir qui ne devrait pas s’y trouver.
- Répond en un quart de seconde. Chaque requête prend 0,15 s, alors une alerte arrive à votre équipe pendant que l’incident se déroule encore.
- Plus constant sur les incidents évidents. Quand un incident est clair, Talos 1.1 garde l’alerte au lieu de la remettre en question.